您可以点击 IEEE Xplore 了解和阅读完整的会议论文,当前解读仅作为该论文因篇幅限制的一些补充解读和说明,建议在阅读本解读和说明前,先行阅读会议论文。
1. 总体设计理念
超参数系统并非一组独立的人工调参常量,而是与数据生成器、物理约束、不确定性估计机制以及训练目标相互耦合的整体。
中心原则是:每一个超参数都应对应学习过程中的一个特定决策:
- 数据生成器决定模型会遇到哪些物理状态与扰动;
- 物理门控模块决定一个预测是否物理上可接受;
- 扰动字典决定一个区域是否类似于某种已知的结构化扰动;
- 不确定性模块决定模型是否应当信任自己的预测;
- 拒绝机制决定一个不可靠的预测是否应被丢弃;
- 主动查询机制决定是否应在某个不确定状态附近追加生成训练样本;
- 损失权重决定这些目标在优化过程中的相对重要性。
因此,改变一个超参数可能不仅改变网络的数值优化行为,还可能改变后续迭代中所生成训练数据的有效分布。
这使得超参数系统成为一个耦合系统,而非传统的扁平参数列表。整体关系如图 1 所示。
图 1 物理引导数据生成与模型更新的闭环主动学习框架
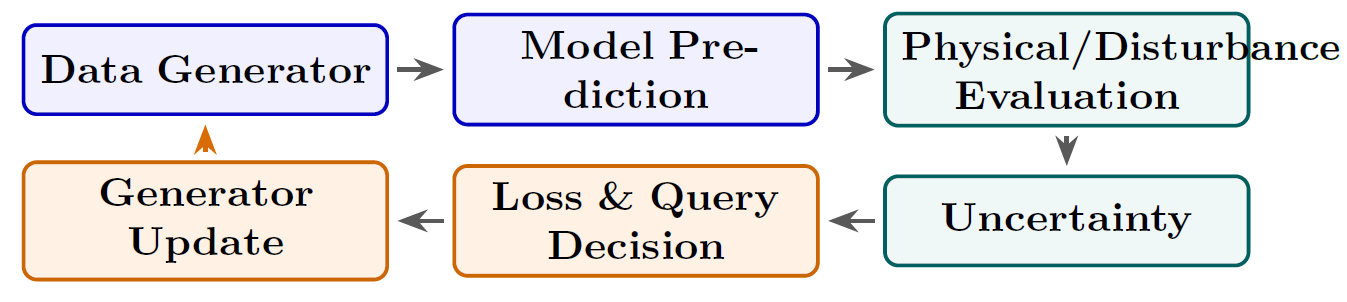
理解这种闭环关系,是理解"为何真正自由的参数只有有限几个"的关键。
2. 数据生成器——超参数系统的源头
数据生成器定义了有效训练分布。
生成器并不直接生成任意的干涉图,而是在前述变换连续相位空间中运作:理想物理状态首先被表示为一个连续变换平面,随后通过对该平面的受控修改引入不同的物理与非物理效应。例如:
$$\begin{aligned} \text{平面倾斜} &\rightarrow \text{条纹取向与相位梯度}, \\ \text{平面梯度} &\rightarrow \text{条纹间距与物理状态}, \\ \text{表面粗糙度} &\rightarrow \text{噪声与局部扰动}, \\ \text{局部变形} &\rightarrow \text{结构化畸变}, \\ \text{局部挖除} &\rightarrow \text{遮挡、阴影或信号丢失}. \end{aligned}$$
被修改的变换平面随后通过逆变换映射回去,生成对应的干涉图。
因此,生成器可被视为拥有若干组生成参数:
$$\boldsymbol{\theta}_{gen} = \{ \boldsymbol{\theta}_{phy}, \boldsymbol{\theta}_{rough}, \boldsymbol{\theta}_{defect}, \boldsymbol{\theta}_{noise}, \boldsymbol{\theta}_{seed} \}.$$
其中 $\boldsymbol{\theta}_{phy}$ 描述物理状态,其余参数描述逐级复杂的扰动。
一个重要的推论是:生成样本的"难度"本身可以用这些参数来解释。例如:
$$D(x) = f(\text{扰动幅度}, \text{缺陷面积}, \text{噪声水平}, \text{物理偏离}, \text{参数复杂度}).$$
因此,"训练难度"不是一个独立的人为变量,而是由生成器所用的物理与扰动参数诱导出来的。
这为将超参数系统与课程学习、主动查询相耦合提供了基础。
3. 损失函数组成
完整训练目标为:
$$\mathcal{L} = \mathcal{L}_{wnll} + \lambda_{phy}\mathcal{L}_{phy} + \lambda_{dis}\mathcal{L}_{dis} + \lambda_{reg}\mathcal{L}_{reg}.$$
四个分量作用于生成数据与真实数据的不同侧面。
3.1 加权负对数似然
$\mathcal{L}_{wnll}$ 在有标签的合成域 $\mathcal{D}_s$ 上评估。
由于数据生成器为合成样本提供了真值物理状态,该损失在异方差高斯形式下同时训练模型估计物理量及其预测不确定性。
因此,合成数据生成器提供了 $\mathcal{L}_{wnll}$ 所需的监督信号。
这是生成器必须保持"生成图像与真值之间已知物理对应关系"的根本原因:如果生成器引入了一个连其物理解释都不知晓的图像扰动,那么该扰动就不能被安全地用作监督训练样本。
3.2 物理一致性损失
$\mathcal{L}_{phy}$ 在无标签的真实域 $\mathcal{D}_t$ 上评估。
物理约束通过 stop-gradient(停止梯度)操作施加。因此,物理约束并不直接强制均值预测服从约束,而是主要作用于预测的不确定性。
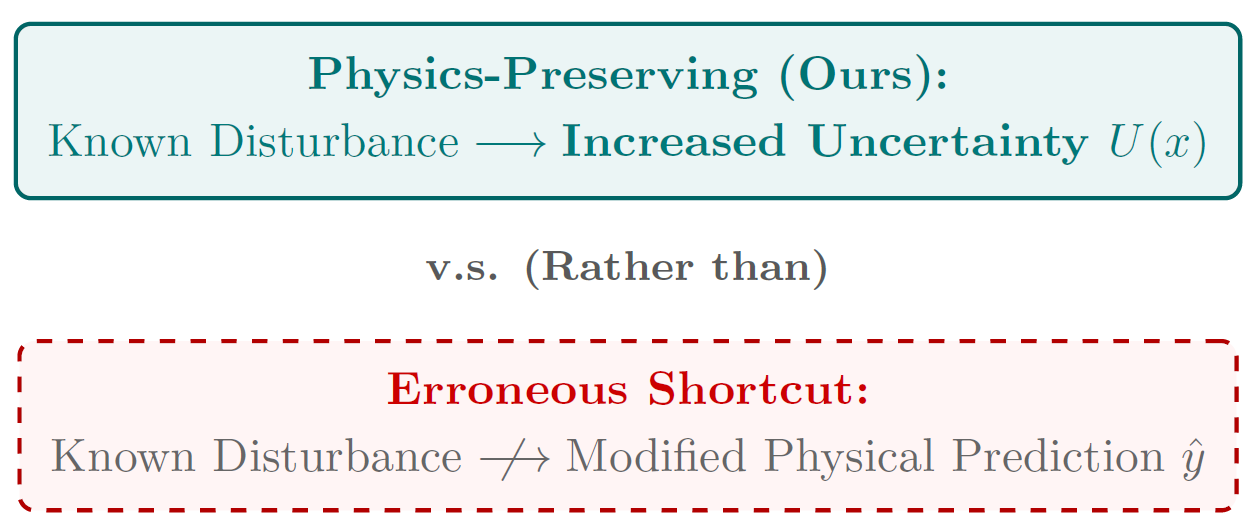
这一区别十分重要。假设真实图像中存在一个区域,其物理本原的物理解释与已知干涉过程不一致。传统的一致性损失可能会迫使网络修改其预测,直到约束"看起来"被满足。
这制造了一条危险的捷径:
$$\text{物理上不可能的区域} \rightarrow \text{被编造但平滑的预测}.$$
本设计则鼓励:
$$\text{物理上不一致的区域} \rightarrow \text{更高的不确定性}.$$
这与数据生成器特别兼容,因为生成器明确提供了有效扰动与无效扰动的实例。物理损失因此学习以下两者的边界:
$$\boxed{\text{物理上允许的生成状态}} \quad \text{与} \quad \boxed{\text{物理上不可信的状态}}.$$
3.3 扰动字典损失
$\mathcal{L}_{dis}$ 作用于扰动字典。
数据生成器提供划痕、坏点、照明缺陷、传感器噪声模式等结构化扰动,以及其他依赖器件的伪迹。字典学习潜在原型:
$$\mathcal{D} = \{ \mathbf{z}_k \}_{k=1}^{K}.$$
其目标是使属于相似扰动类别的样本围绕相应原型聚类,同时防止所有原型坍塌为同一表示。
因此,$K$ 不仅仅是一个神经网络架构参数,它代表了仿真器所生成的扰动空间的假定容量。
3.4 正则化
$\mathcal{L}_{reg}$ 不对应某个特定物理现象,而是用于稳定预测、物理一致性、扰动识别与不确定性的联合优化。
这一区分是有意为之:$\mathcal{L}_{wnll}, \mathcal{L}_{phy}, \mathcal{L}_{dis}, \mathcal{L}_{reg}$ 不应被视为改进同一目标的可互换手段,它们对应四种不同能力:
$$\boxed{\text{预测}} + \boxed{\text{物理有效性}} + \boxed{\text{扰动识别}} + \boxed{\text{数值稳定性}}$$
4. 物理门控超参数与数据生成器
物理门控参数应当相对于生成器所产生的物理状态范围来解读。
4.1 $\alpha_{\max}$
时间门控使用一个物理相位速度的允许上界:
$$v_i^{\max} = f(\alpha_{\max}, \Delta T_i, \Delta t_i, \kappa).$$
重要的是,$\alpha_{\max}$ 不被当作普通可调超参数,它代表由已知材料类别物理性质导出的保守上界。
数据生成器因此必须遵守同一物理范围,这产生一条重要的一致性要求:
$$\boxed{\text{生成器物理范围} \subseteq \text{物理允许范围}}$$
如果生成器例行地生成物理允许范围之外的状态,而物理门控又将这些状态判为不可能,模型就会收到自相矛盾的训练信号。
因此,$\alpha_{\max}$ 同时是:
- 物理门控的一个参数;
- 对数据生成器物理有效区域的约束。
故它更适合被描述为一个物理边界条件,而非自由超参数。
4.2 $\kappa_{sp}$ 与 $\kappa_{tmp}$
参数 $\kappa_{sp}, \kappa_{tmp}$ 控制空间门控与时间门控的锐度。
它们的作用不是定义什么是物理有效的,而是定义软约束从"接受"过渡到"拒绝"的速度:
- 若 $\kappa \rightarrow \infty$,软门控趋近硬阈值。这可能导致提供给"生成器—模型"系统的梯度过度局部化,并可能助长捷径求解;
- 反之,若 $\kappa \rightarrow 0$,门控过于软化,无法区分有效区域与无效区域。
因此,合适的取值不一定是验证集上的单一最优点,更可取的是一个稳定拒绝性能的平台区。这对数据生成器尤其重要,因为生成器在连续的扰动严重度范围内产出样本,门控应当在过渡区提供平滑响应,而不是在"干净"与"无效"之间突然切换。
5. 空间阈值($\tau_{sp}$)与生成器校准
空间阈值 $\tau_{sp}$ 应当对照生成样本的分布来校准。
生成器可以产出两个参考总体:$\mathcal{D}_{clean}$ 与 $\mathcal{D}_{defect}$。前者包含物理有效、相对干净的干涉图样,后者包含刻意引入的缺陷。
相应的空间一致性得分产生两个经验分布:
$$p(s \mid \mathcal{D}_{clean}), \qquad p(s \mid \mathcal{D}_{defect}).$$
$\tau_{sp}$ 的初值因此选在这两个分布开始分离的区域附近(见图 2)。
图 2 基于干净与缺陷参考总体的经验得分分布校准门控阈值与门控锐度
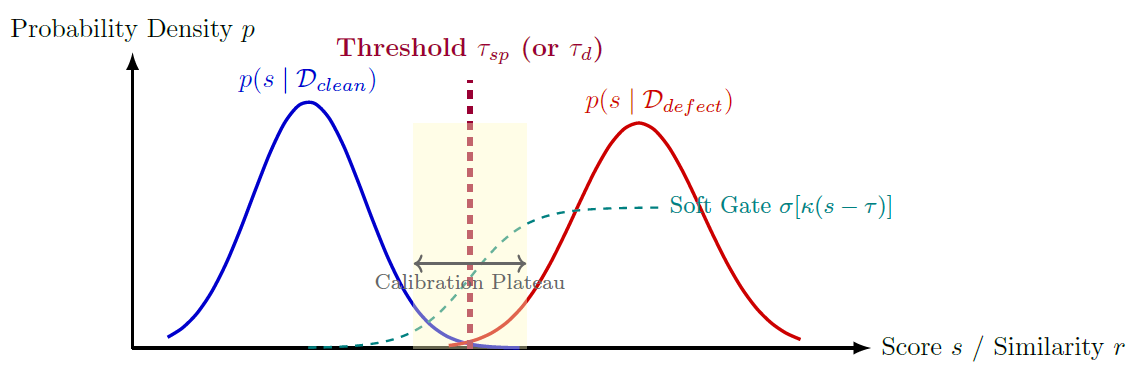
这比任意选取一个数值阈值更可取,因为阈值的含义取决于具体的变换与数据生成过程。换言之:
$$\boxed{\tau_{sp} \text{ 由生成器的物理样本分布校准。}}$$
这也解释了为何改变生成器的扰动模型可能需要重新校准门控阈值。
6. 扰动字典容量($K$)
字典容量 $K$ 与生成器所表示的扰动多样性直接相关。假设生成器包含以下几个大的扰动家族:
$$\{ \text{划痕}, \text{坏点}, \text{灰尘}, \text{晕影}, \text{传感器噪声}, \text{局部遮挡}, \ldots \}.$$
则 $K$ 应当足够大,以表示这些扰动的主要潜在模式。
然而,$K$ 不需要等于人工定义的扰动类别数:单一物理扰动可能对应多个潜在原型,因为其外观随位置、严重程度、朝向或与其他扰动的交互而变化;反之,若干视觉上不同的扰动也可能共享同一潜在表示。
因此,$K$ 应被解读为潜在字典容量,而非缺陷类型的字面数量。归一化与防坍塌项降低了冗余原型的风险,使 $K$ 的初值可以略微过完备。
7. $\kappa_{dis}$、$\tau_d$ 与扰动生成器
对于编码特征 $\mathbf{f}_i$,字典产出一个相似度得分:
$$r_i = \max_k \frac{\langle \mathbf{f}_i, \mathbf{z}_k \rangle}{\|\mathbf{f}_i\|_2 \|\mathbf{z}_k\|_2 + \epsilon}.$$
扰动置信度为:
$$g_i^{dis} = \sigma \left[ \kappa_{dis}(r_i - \tau_d) \right].$$
因此,这两个参数应从生成扰动分布的角度来解读:
- $\tau_d$ 决定多高的相似度才足以将一个特征归类为属于某种已知扰动模式;
- $\kappa_{dis}$ 决定该决策的锐度。
校准过程同样可以使用生成的干净样本与受扰样本。例如,可将 $p(r \mid \mathcal{D}_{clean})$ 与 $p(r \mid \mathcal{D}_{disturbance})$ 进行比较,阈值置于两者有效分离的区域附近。这使得扰动字典直接依赖于数据生成器,而非一个孤立的特征学习组件。
8. 方差膨胀($\gamma_{dis}$)
调整后的方差为:
$$\widehat{\sigma}_{i,adj}^{2} = \widehat{\sigma}_{i}^{2} + \gamma_{dis}g_i^{dis}.$$
$\gamma_{dis}$ 的目的尤其重要:字典不直接修改预测的物理均值,其作用机制如图 3 所示。
图 3 物理保持机制与错误捷径的对比
显式条件
$$\boxed{\gamma_{dis} \ge \tau_{var}}$$
确保足够强的字典匹配可以将调整后方差推过拒绝边界。
因此,$\gamma_{dis}$ 应当在 $\tau_{var}$ 确立之后才选取。这产生一个参数依赖关系:
$$\tau_{var} \rightarrow \gamma_{dis}.$$
这一顺序不应颠倒。
9. 拒绝阈值($\tau_{var}$)
在所有超参数中,$\tau_{var}$ 是最不适合做盲目的验证集优化的参数之一。它由风险分解导出:
$$\tau_{var} \le \frac{\tau_{rej} - \delta}{2} - \epsilon_\sigma.$$
其中:
- $\tau_{rej}$ 为最大可接受拒绝风险;
- $\delta$ 为物理门控偏差界;
- $\epsilon_\sigma$ 为不确定性校准误差。
因此:
$$\boxed{\tau_{rej}, \delta, \epsilon_\sigma \rightarrow \tau_{var}} \quad \text{而非} \quad \text{验证集搜索} \rightarrow \tau_{var}.$$
这一区别很重要,因为它使拒绝阈值可以从风险角度解释,而非仅仅出于经验性能。
数据生成器在此间接但根本地参与:$\epsilon_\sigma$ 的校准取决于生成的扰动分布在多大程度上代表了模型所遇到的不确定性模式。
10. 主动查询与数据生成器
主动查询机制是超参数系统与数据生成器耦合最显式之处。
模型首先产出一个不确定性表示 $U(x)$。若
$$U(x) > \tau_U,$$
该样本便成为追加仿真的候选。生成器随后在一个局部物理参数邻域内搜索:
$$\theta' \in B(\theta, r_q).$$
这里 $r_q$ 不单是图像空间上的增强半径,而是底层物理参数空间中的半径。
例如,若生成状态由 $\theta = (\theta_{wedge}, \theta_{noise}, \theta_{rough}, \theta_{defect}, \ldots)$ 描述,则主动查询生成附近的状态:
$$\theta' = \theta + \Delta\theta.$$
由此,生成样本在模型的不确定性周围形成一个局部邻域。
这是与传统数据增强的关键区别:
- 传统增强可能会问:"如何让这张图像稍有不同?"
- 主动仿真器问的是:"哪个邻近的物理状态对消解模型当前的不确定性最有用?"
11. 查询半径($r_q$)
查询半径必须相对于物理参数的自然变化尺度来定义。
若 $r_q$ 过大,生成器可能离开观测的物理上有意义的邻域,生成孤立看技术上有效、但与当前不确定性无关的样本;若过小,则 $\theta' \approx \theta$,新样本包含的信息不足以改进模型。
合适的尺度因此与参数的自然变化相关:
$$r_q \sim c \cdot \sigma_{\theta},$$
其中 $c$ 是一个较小的比例因子,$\sigma_\theta$ 表示相应参数的自然变化尺度。
这使 $r_q$ 成为又一个"其含义来自生成器而非神经网络"的超参数例证。
12. 查询目标与 $\beta$
主动仿真器并不只是单纯最大化不确定性,它需要在保持与原始观测足够接近的同时最大化不确定性。概念上,查询目标可写为:
$$J(\theta') = U(\theta') - \beta D(\theta', \theta).$$
第一项鼓励生成器搜索对模型构成挑战的样本;第二项防止生成器任意远离当前物理状态。
因此,$\beta$ 控制着以下两者之间的平衡:
$$\boxed{\text{探索}} \quad \text{与} \quad \boxed{\text{局部物理相关性}}.$$
若 $\beta$ 过小,主动查询退化为全局不确定性最大化;若 $\beta$ 过大,生成样本与原始点过于接近,提供的新增信息很少。
一个实用的初始化方式是将两项归一化,使其在正常工作范围内具有可比的数值量级。
13. 不确定性触发($\tau_U$)
阈值 $\tau_U$ 控制模型何时被视为"足够不确定"从而请求追加数据,因此它间接控制了仿真器的计算预算:
$$\begin{aligned} \text{低阈值} &\rightarrow \text{多次查询} \rightarrow \text{更多合成数据} \rightarrow \text{更高仿真成本}, \\ \text{高阈值} &\rightarrow \text{少量查询} \rightarrow \text{较低仿真成本(有漏掉有用困难案例的风险)}. \end{aligned}$$
因此,$\tau_U$ 可以根据期望的查询频率来校准,而非简单地最大化验证精度。这也是数据生成器与超参数系统不可分割的又一原因:$\tau_U$ 实际上决定了生成器被允许介入训练的频繁程度。
14. 全局不确定性权重
全局不确定性得分可表示为:
$$U = \omega_1 U_{pred} + \omega_2 U_{phy} + \omega_3 U_{dis}.$$
三个分量在概念上对应:
$$\begin{aligned} U_{pred} &\rightarrow \text{模型不确定性}, \\ U_{phy} &\rightarrow \text{物理不一致性}, \\ U_{dis} &\rightarrow \text{已知扰动}. \end{aligned}$$
取相等的初始权重是合理的,因为在校准之前没有理由假设单一不确定性来源占主导。后续调整应基于哪个分量对"错误触发查询"贡献过大。
重要的是,这些权重决定了数据生成器响应哪一类困难。例如,增大 $\omega_{phy}$ 使生成器对物理不一致样本更敏感,而增大 $\omega_{dis}$ 使其对结构化器件扰动更敏感。
因此,$\omega_1, \omega_2, \omega_3$ 可被解读为主动数据生成中不同失效模式的相对优先级。
15. 损失权重与生成器难度
损失权重 $\lambda_{phy}, \lambda_{dis}, \lambda_{reg}$ 不应脱离数据生成器来解读。
一个实用的初始化流程是:先用 $\mathcal{L}_{wnll}$ 单独训练,让网络建立起从合成观测到物理量的基本映射;待该基线稳定后,再逐步引入物理损失、扰动损失与正则化损失。
其原因与数据生成器实现的课程密切相关:
$$\begin{aligned} \text{初期:}\quad & \text{简单物理状态} \rightarrow \text{基础监督学习}. \\ \text{然后:}\quad & \text{结构化扰动} \rightarrow \text{扰动识别}. \\ \text{再后:}\quad & \text{更难的物理不一致} \rightarrow \text{物理门控}. \\ \text{最后:}\quad & \text{不确定的局部状态} \rightarrow \text{主动查询}. \end{aligned}$$
因此,损失权重决定了模型对这一逐级复杂的数据分布的每个阶段的响应强度。
16. 拒绝成本($\lambda_{rej}$)
拒绝成本控制模型的保守程度。概念上,优化中存在一场竞争:
$$\text{做出预测} \quad \text{vs.} \quad \text{拒绝预测}.$$
若 $\lambda_{rej}$ 过小,拒绝变得廉价,模型可能几乎拒绝一切;若过大,拒绝变得过于昂贵,模型可能连物理上不可靠的区域也尝试预测。
因此,$\lambda_{rej}$ 的初始尺度应与典型干净样本的负对数似然相当,使拒绝既不是轻易的逃生通道,也不是代价过高的动作。
从数据生成器的角度看,这一参数尤为重要,因为生成器刻意制造困难样本。系统因此必须区分:
$$\boxed{\text{应当学习的困难样本}} \quad \text{与} \quad \boxed{\text{根本上不可信、应当拒绝的样本}}.$$
拒绝成本决定了这条边界的一部分。
17. 特征幅度正则化
特征幅度系数 $\varsigma$ 不代表物理性质,因此不应被解读为仿真器物理模型的一部分。它的目的是数值性的。
数据生成器在课程学习与主动查询过程中可能生成愈发严重的扰动,特征分布可能变得愈发极端。正则化项防止特征幅度在训练分布变难时变得数值不稳定。
因此,$\varsigma$ 在模型侧起防护作用,而数据生成器在数据侧控制复杂度。
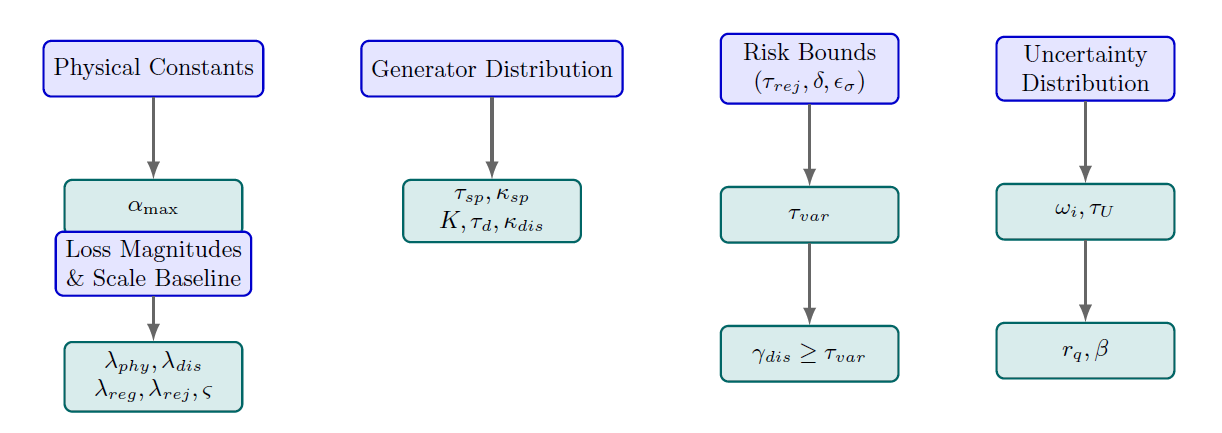
18. 参数依赖图
因此,完整系统更适合表示为一张依赖图,而非一张扁平表格。简化的依赖结构为:
$$\boxed{\text{物理常数} \rightarrow \alpha_{\max}} \qquad \boxed{\text{生成器分布} \rightarrow \tau_{sp}, \kappa_{sp}, K, \tau_d, \kappa_{dis}}$$
$$\boxed{\tau_{rej}, \delta, \epsilon_\sigma \rightarrow \tau_{var} \rightarrow \gamma_{dis}} \qquad \boxed{\text{不确定性分布} \rightarrow \omega_i, \tau_U \rightarrow r_q, \beta}$$
$$\boxed{\text{损失量级} \rightarrow \lambda_{phy}, \lambda_{dis}, \lambda_{reg}, \lambda_{rej}}$$
数据生成器位于第一组与第四组的中心,因为它既决定了门控参数校准所对照的分布,也决定了响应主动查询而产出的样本(见图 4)。
图 4 参数依赖有向无环图(DAG):层级推导与物理 / 统计锚定
19. 自由与非自由超参数
由此,超参数系统应划分为三类:
A 类:物理决定参数 —— 不是自由参数:
$$\alpha_{\max}.$$
它们由物理知识与保守安全边际决定。
B 类:数学约束参数 —— 不允许自由优化:
$$\tau_{var}, \qquad \gamma_{dis} \ge \tau_{var}.$$
其取值受风险分解与显式不等式条件约束。
C 类:经验校准参数,包括:
$$\kappa_{sp}, \kappa_{tmp}, \tau_{sp}, K, \kappa_{dis}, \tau_d, \omega_1, \omega_2, \omega_3, \tau_U, r_q, \beta, \lambda_{phy}, \lambda_{dis}, \lambda_{reg}, \lambda_{rej}, \varsigma.$$
然而,即便是这些参数也不应被一视同仁地视为自由参数:其中一些对照数据生成器产出的分布校准,另一些对照优化的数值行为校准。这一区别十分重要。
20. 最终闭环解释
因此,对超参数系统最完整的解读不是
$$\boxed{\text{超参数} \rightarrow \text{网络训练}}$$
而是一个自适应的闭环动态流水线(见图 5)。
图 5 耦合超参数系统、物理验证、不确定性过滤与主动仿真迭代的综合闭环交互
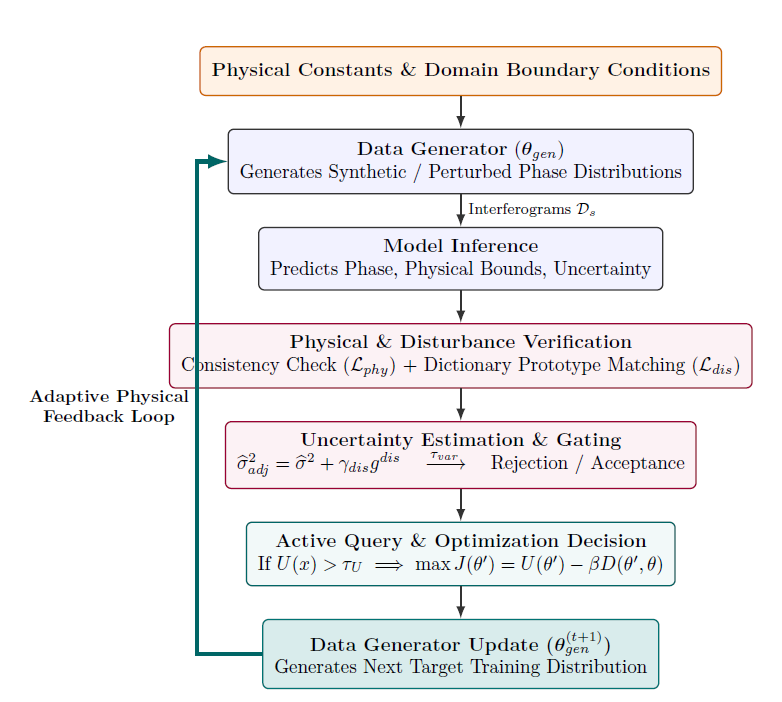
这意味着有效训练分布本身是自适应的:模型不是简单地从固定的合成数据集学习,而是仿真器根据模型已学到的内容及其仍然不确定的地方,逐步改变数据分布。
由此,超参数系统不仅定义了优化地形,还定义了物理仿真空间的边界、生成扰动的严重程度、物理拒绝的敏感度,以及新训练数据生成的条件。
这正是为何超参数系统表面上的复杂性不应被解读为大量任意可调参数的堆砌。大多数参数源于以下四个来源之一:
$$\boxed{\text{物理知识}}, \quad \boxed{\text{生成器统计}}, \quad \boxed{\text{理论约束}}, \quad \boxed{\text{优化稳定性}}.$$
只有相对较小的子集是真正自由的。
请引用已发表的文献如下:
D. Huang, J. Wang and J. Li, "Bridging the Sim2Real Gap via Physics-Constrained Gating and Disturbance Dictionary Learning," 2026 International Conference on Emerging Techniques in Computational Intelligence (ICETCI), Hyderabad, India, 2026, pp. 1-6, doi: 10.1109/ICETCI71772.2026.11710440.